


 +7 383 380-81-89
Классификация обращений граждан с помощью ИИ: сервис для Минцифры
Сервис читает обращение гражданина, даже скан или письмо от руки, и сам предлагает, как его зарегистрировать: темы по официальному классификатору, вид и тип вопроса. Сотрудник приёмной проверяет готовый список, а не ищет темы с нуля среди 1 870.
- Клиент
- Минцифра
- Отрасль
- Госсектор
- Кто пользуется
- Управление по работе с обращениями граждан - общественная приёмная Губернатора Новосибирской области
- Задача
- Темы, вид и тип вопроса для регистрации обращений
- Что делали
- Распознавание, обезличивание, несколько тем, панель сотрудника, сверка с экспертами
- Стадия
- Передано заказчику на развёртывание 12.10.2026
Оглавление
- Кто клиент и кто работает с сервисом
- Задача: 200 обращений в день и три дня на регистрацию
- Почему это трудно: классификатор на 1 870 тем
- Как устроен сервис: от письма до тем для регистрации
- Первый этап: одна тема на обращение
- Главная причина ошибок: сервис читал только первую страницу
- Несколько тем в одном обращении
- Подсказки оператору: проверить быстрее, чем выбрать самому
- Автомат или на сверку
- Пример: как сервис разобрал одно обращение
- Проверка с экспертами приёмной
- Сколько времени и денег уходит на одно обращение
- Персональные данные и безопасность
- Что получилось
- Кому подойдёт такой сервис
- Для технических специалистов
Мы сделали для Минцифры сервис, который читает обращение гражданина и сам предлагает, как его зарегистрировать: тематику, вид и тип вопроса по официальному классификатору. Сервис понимает сканы, фото и рукописные письма, находит в одном обращении сразу несколько тем и объясняет каждую короткой фразой. Последнее слово остаётся за сотрудником приёмной.
Перед передачей сервис проверили эксперты общественной приёмной. В обращениях с несколькими темами он нашёл 80% тем, и 96% из того, что он выдал, оказалось верным. 12 октября 2026 года мы передали заказчику исходный код, готовый к запуску контейнер и инструкцию. Запускает сервис у себя служба заказчика.
Кто клиент и кто работает с сервисом
Заказчик: Минцифра. Мы работаем с ней не первый год. Для неё же мы сделали систему, которая сверяет документы закупки до размещения.
Пользуется сервисом Управление по работе с обращениями граждан (общественная приёмная Губернатора Новосибирской области). Это сотрудники, которые принимают письма граждан, регистрируют их и передают дальше тем, кто будет отвечать по существу. Обращения приходят с сайтов многих ведомств, примерно 200 в день.
Регистрация идёт в СЭДД. Так называется система электронного документооборота: в ней ведомство ведёт входящие письма, поручения и ответы. Зарегистрированное обращение попадает к тем, кто его рассматривает, и они дают гражданину ответ.
Задача: 200 обращений в день и три дня на регистрацию
Что видели. Каждое обращение сотрудник приёмной читает целиком. Потом находит в классификаторе подходящие темы, ставит вид и тип вопроса и только после этого регистрирует. Письмо может быть на одну страницу, а может на тридцать. Может прийти скан от руки, фото с телефона или документ Word.
При этом сроки задаёт закон. Письменное обращение нужно зарегистрировать в течение трёх дней с момента поступления. Так сказано в части 2 статьи 8 Федерального закона № 59-ФЗ «О порядке рассмотрения обращений граждан Российской Федерации». Граждане пишут и в праздники, и эти письма тоже нужно успеть зарегистрировать в срок.
Что хотел заказчик. Ускорить регистрацию и снять с людей ручную часть. Схема, к которой идёт заказчик, выглядит так:
- Обращение забирают с сайта ведомства.
- Сервис читает его и выдаёт тематику, вид и тип вопроса.
- Данные для регистрации автоматически уходят в СЭДД.
- Сотрудники рассматривают обращение и отвечают гражданину.
Наша часть в этой схеме: второй шаг. Мы сделали сервис, который по тексту или файлу обращения возвращает всё нужное для регистрации. Связку с СЭДД заказчик делает сам, в своём контуре.
Почему это трудно: классификатор на 1 870 тем
Темы обращений не придумывают каждый раз заново. Есть официальный классификатор, в проекте мы работали с редакцией от 31 октября 2025 года. В нём три уровня.
- Вид вопроса. Всего 9 видов. Например, «Заявление».
- Тип вида вопроса. Уточняет вид. Например, «Сообщение автора обращения о недостатках в работе органов местного самоуправления».
- Тематика. Около 1 870 конечных тем в 5 разделах. У каждой свой длинный код, например 0003.0009.0097.0690 «Уличное освещение».
Сложность в том, что темы часто стоят рядом и отличаются одним словом. «Ремонт автомобильных дорог» и «Содержание автомобильных дорог» лежат в одной рубрике. Человек без опыта легко перепутает их, нейросеть тоже.
Вторая сложность: в одном письме бывает много тем. Гражданин пишет про дорогу, а заодно про школьный автобус, свет на улице и про то, что администрация отвечает отписками. По словам заказчика, рекорд был 12 тем в одном обращении. Каждую нужно отметить при регистрации, иначе часть просьб никто не рассмотрит.
Как устроен сервис: от письма до тем для регистрации
Сервис работает по шагам. Сотрудник видит только начало и конец: загрузил обращение, получил список тем.
- Приём. На вход идёт текст или файл: PDF, DOCX, скан, фото. Подходят и рукописные письма, для них есть отдельная галочка, тогда текст читает более точная модель.
- Распознавание. Сервис превращает картинку страницы в текст.
- Обезличивание. Фамилии, имена, телефоны и адреса заменяются метками. Дальше по цепочке идёт текст уже без них.
- Подбор тем. Нейросеть сверяет текст с классификатором и выбирает основную тему, дополнительные и запасные варианты. К каждой теме пишет короткое объяснение, почему она здесь.
- Вид и тип вопроса. Определяются отдельно, тоже по классификатору.
- Решение: автомат или на сверку. Если сервис уверен выше заданного порога, обращение может идти дальше без человека. Если нет, оно уходит сотруднику на проверку.
Для сотрудника есть веб-форма. Для системы заказчика есть программный интерфейс с документацией: через него обращения можно отправлять в сервис без участия человека.
Первый этап: одна тема на обращение
Проект шёл в два этапа. На первом разработчик La Chatte собрал сервис, который выдавал одну тему на обращение. Так приёмная могла сразу посмотреть, как нейросеть справляется с классификатором.
Для проверки заказчик дал нам обращения с разметкой своих экспертов:
- 20 обращений с одной темой, 16 из них эксперты разметили;
- 8 обращений с несколькими темами.
Итог первого этапа. В обращениях с одной темой главная тема совпала с экспертами в 12 случаях из 16. В обращениях с несколькими темами сервис находил 3% тем эксперта. Он всегда возвращал одну тему, а в этих письмах их было много.
С 6 октября 2026 года начался второй этап: найти, где сервис ошибается, научить его нескольким темам и подготовить к передаче.
Главная причина ошибок: сервис читал только первую страницу
Что видели. Сначала мы проверили, что сервис вообще видит. Взяли каждое обращение и сравнили: сколько текста в файле и сколько дошло до классификации.
Нашли главную причину ошибок. Из длинного PDF модель распознавания возвращала только первую страницу. В одном обращении было 27 страниц, около 62 тысяч символов. До подбора тем доходило около 1,5 тысячи. Остальное терялось, и сервис выбирал тему по вступлению, не дочитав, о чём просит человек.
Что сделали. Перевели распознавание на части по 3 страницы. Части читаются одновременно, потом текст собирается обратно по порядку. Обращение на 27 страниц теперь распознаётся примерно за 30 секунд, и текст доходит целиком.
Что получили. Только это исправление подняло точность на обращениях с одной темой с 12 до 15 из 16. Подбор тем мы на этом шаге не трогали: сервису просто дали прочитать письмо полностью.
Несколько тем в одном обращении
Что видели. Обычный приём «спросить нейросеть, какие тут темы» даёт короткий список. Модель называет самую заметную просьбу и пару похожих и пропускает остальное. Например, просьбу про дорогу заметит, а то, что автор многодетная мать, уже нет. А для регистрации это отдельная тема.
Что сделали. Разбили работу на два прохода.
Первый проход собирает широкий список кандидатов по всему классификатору. Сервис ищет в письме четыре вида тем:
- предмет каждой просьбы: о чём человек просит, по пунктам;
- категория заявителя: инвалид, ветеран боевых действий, семья с детьми;
- органы, на чьи ответы жалуется автор: если человек пишет, что администрация присылает отписки, это тоже тема;
- сопутствующие беды: то, о чём автор пишет попутно, но что тоже требует внимания.
Второй проход отбирает из кандидатов нужные темы. Здесь сервис опирается на примеры разметки экспертов приёмной: как они размечали похожие письма раньше. Примеры перед использованием обезличены.
На выходе сервис отдаёт три списка: основную тему, дополнительные темы и кандидатов, о которых стоит подумать сотруднику. У каждой темы есть короткое обоснование, например «организация школьного подвоза» или «жалоба на бездействие администрации района».
Подсказки оператору: проверить быстрее, чем выбрать самому
Что видели. Даже хороший список тем сотрудник всё равно проверяет. Если для этого нужно открывать классификатор и искать код вручную, выигрыш во времени съедается.
Что сделали. В форму добавили панель «Темы для регистрации». В ней:
- каждая тема стоит с галочкой, лишнюю снимают одним нажатием;
- код можно заменить на соседний из той же рубрики прямо в выпадающем списке, не открывая классификатор;
- ниже свёрнуты запасные кандидаты, их добавляют, если сервис поставил их ниже, чем нужно;
- есть поиск по всему классификатору от трёх букв, если нужной темы нет нигде;
- кнопка «Скопировать итог» забирает готовый список для регистрации.
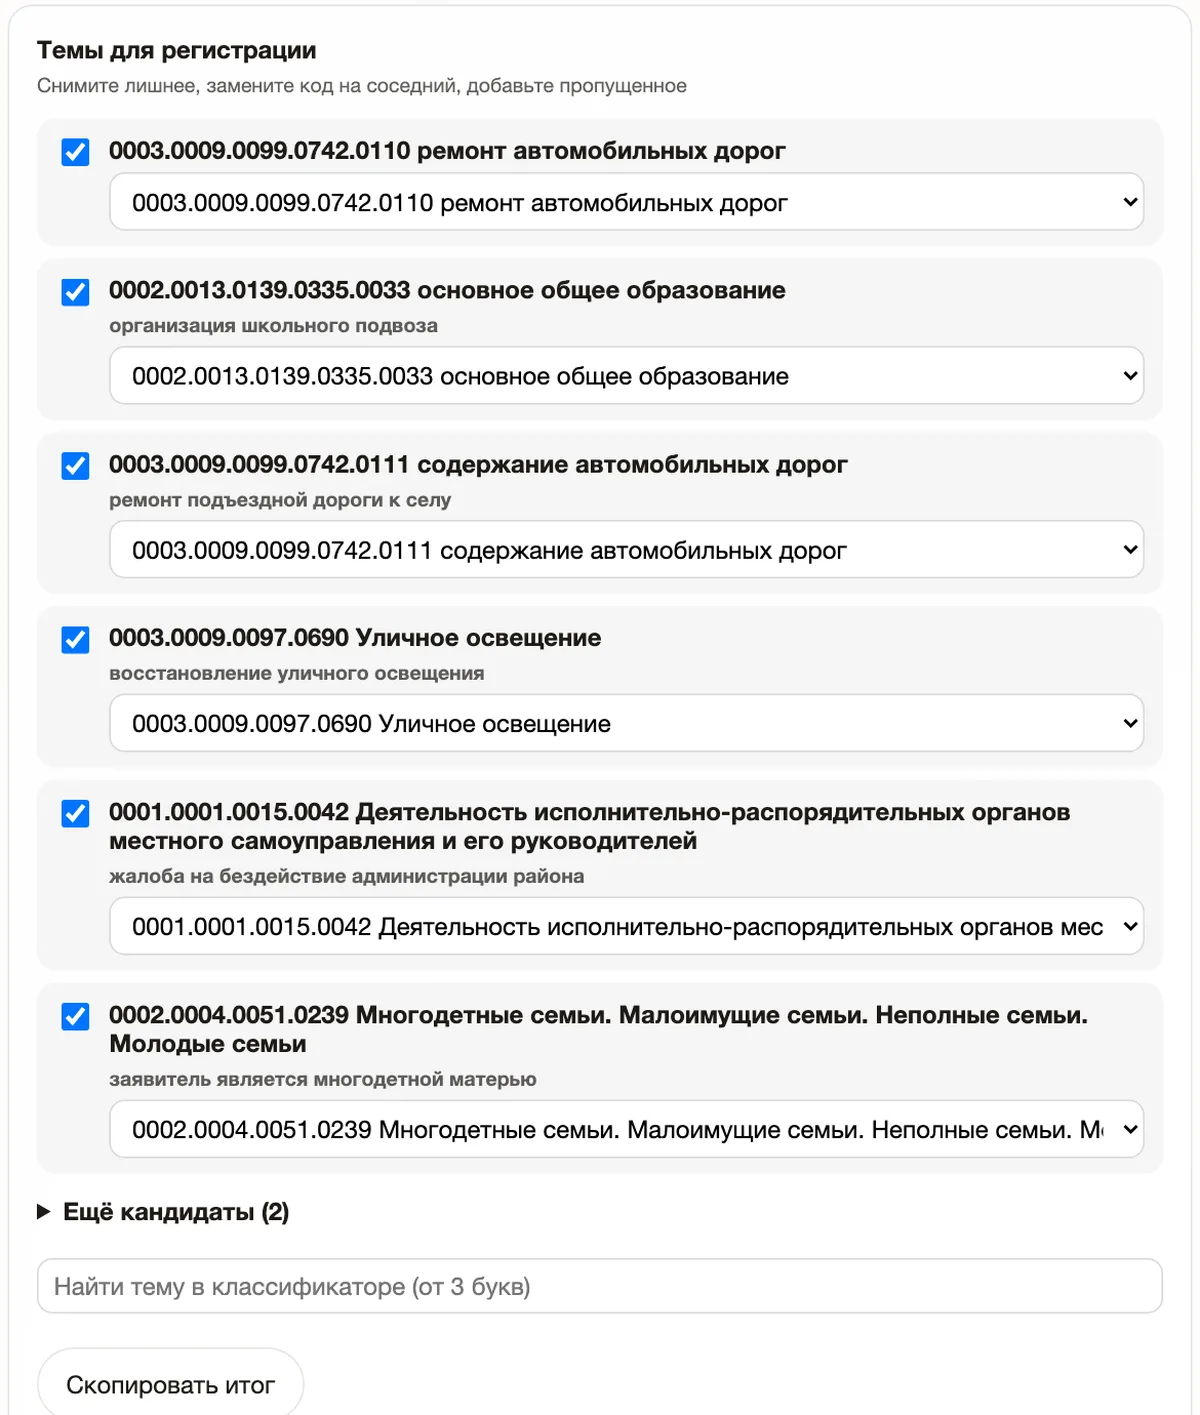
Так работа сотрудника меняется. Раньше он выбирал темы с нуля из 1 870. Теперь он проверяет готовый список с объяснениями и правит его.
Автомат или на сверку
Заказчик хочет, чтобы простые обращения со временем регистрировались без человека. Для этого в сервисе есть порог уверенности. Сервис оценивает, насколько уверен в основной теме, виде и типе вопроса. Если все оценки выше порога, ответ помечается «Автомат». Если хоть одна ниже, ответ помечается «На сверку», и сервис пишет, какая именно оценка не дотянула.
Порог настраивается без переделки сервиса. Сейчас он стоит на максимуме: все обращения идут на сверку сотруднику. Причина простая. На тестовом наборе оценка уверенности пока плохо отличает верные ответы от неверных. Ошибочная тема может прийти с высокой уверенностью, а верная с низкой. Пока это так, отпускать обращения в СЭДД без человека рано.
Порог можно будет снижать, когда у заказчика накопится статистика на живом потоке: какие ответы сотрудники принимают без правок, а какие исправляют.
Пример: как сервис разобрал одно обращение
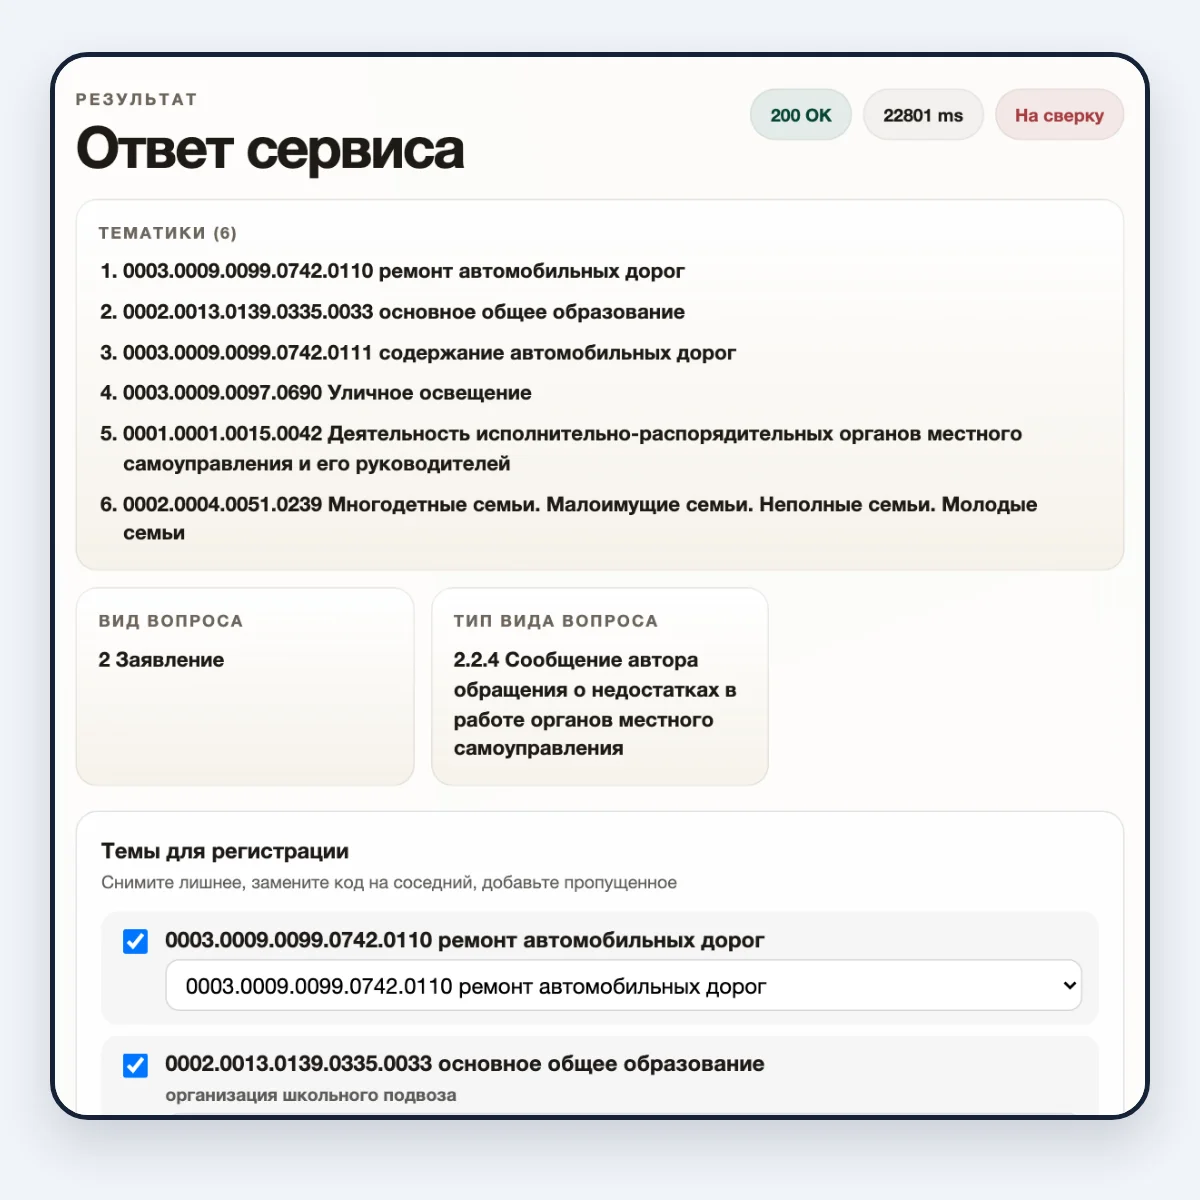
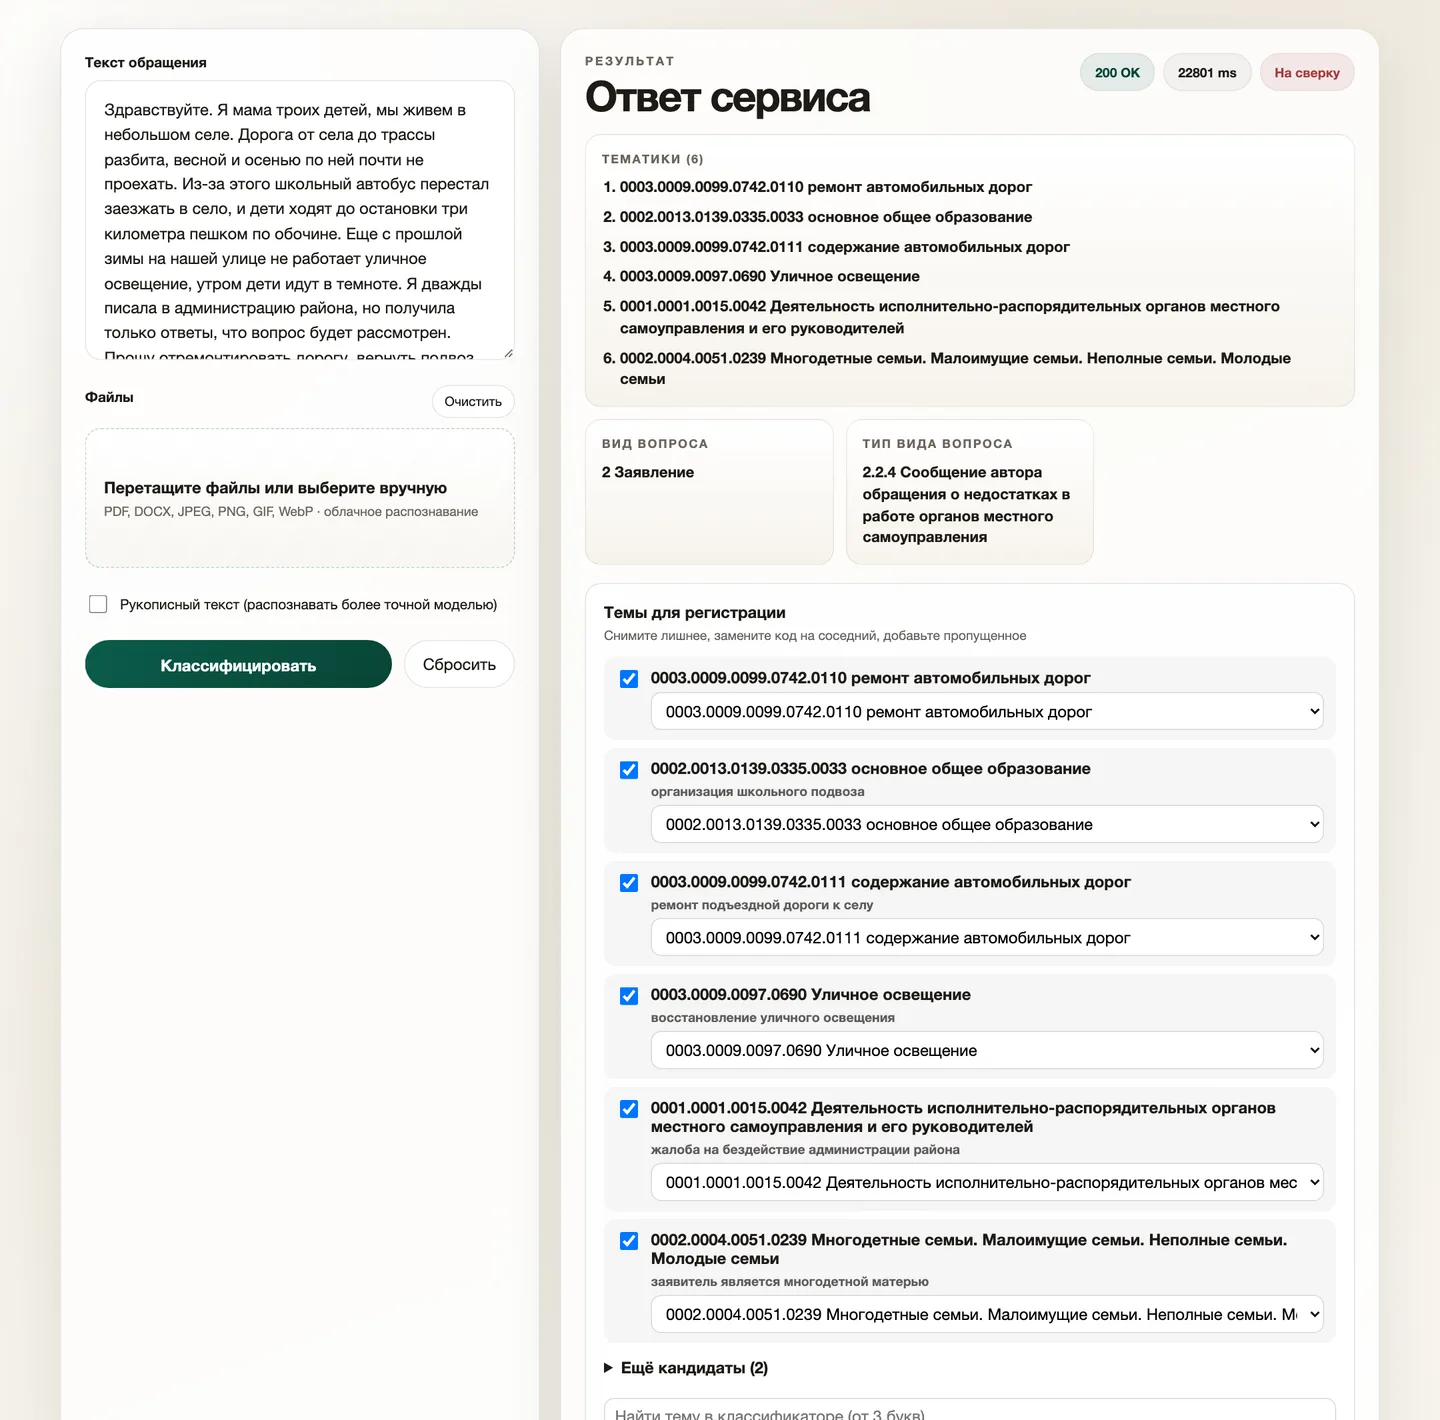
Для этого кейса мы написали обращение сами, чтобы не показывать чужих данных. Многодетная мать из небольшого села пишет: дорога до трассы разбита, школьный автобус перестал заезжать, дети ходят до остановки три километра по обочине, на улице с прошлой зимы нет освещения, администрация района отвечает, что «вопрос будет рассмотрен».
Сервис ответил за 23 секунды. Он выделил шесть тем:
- ремонт автомобильных дорог (основная);
- основное общее образование, с пояснением «организация школьного подвоза»;
- содержание автомобильных дорог: «ремонт подъездной дороги к селу»;
- уличное освещение: «восстановление уличного освещения»;
- деятельность органов местного самоуправления: «жалоба на бездействие администрации района»;
- многодетные семьи: «заявитель является многодетной матерью».
Ещё две темы сервис положил в запасные кандидаты: безопасность дорожного движения (дети идут по обочине) и охрана общественного порядка (на улице темно). Вид вопроса: «Заявление». Тип: «Сообщение автора обращения о недостатках в работе органов местного самоуправления». Решение: «На сверку», потому что порог сейчас стоит на максимуме.
Сотруднику остаётся решить, нужны ли рядом обе дорожные темы, и при необходимости добавить кандидата из запасных.
Проверка с экспертами приёмной
Что видели. Сравнивать сервис с разметкой экспертов «в лоб» оказалось нечестно в обе стороны. Часть тем, которые сервис нашёл сверх разметки, на деле были верными: эксперт их просто не отметил. А иногда сервис ставил соседний код, и неясно было, ошибка это или оба варианта допустимы.
Что сделали. С 6 по 12 октября 2026 года мы собрали таблицу всех расхождений сервиса с экспертами. Эксперты приёмной разобрали каждое расхождение вручную: тема верная, лишняя, подходят оба кода или ошибся эксперт. По их ответам мы пересчитали результат.
| Обращения | Сервис нашёл тем из нужных | Верных среди того, что выдал сервис |
|---|---|---|
| С несколькими темами | 80% (49 из 61) | 96% (52 из 54) |
| С одной темой | 94% (44 из 47) | 74% (46 из 62) |
Как читать таблицу. Первая цифра показывает, сколько нужных тем сервис не упустил. Вторая показывает, сколько из выданных им тем эксперты признали верными. В обращениях с одной темой сервис предлагает больше лишнего: он отдаёт кандидатов с запасом, а сотрудник снимает галочки.
Что ещё выяснилось. Эксперты сами пропустили много тем. В 8 обращениях с несколькими темами после сверки оказалась 61 тема вместо 32 в исходной разметке. В обращениях с одной темой эксперты в нескольких случаях отметили «эксперт пропустил». До проекта эксперты оценивали точность своей разметки в 95%.
Вывод экспертов. Система в большинстве случаев выбирает правильно. Лишняя тема лучше пропуска: она снижает риск, что при регистрации потеряется вопрос гражданина, а лишнюю регистратор просто удалит.
Этот вывод и определил настройку сервиса. Мы держим его в режиме, где он лучше найдёт лишнее, чем упустит нужное.
Сколько времени и денег уходит на одно обращение
- Распознавание: от 5 до 30 секунд, зависит от числа страниц.
- Подбор тем: от 10 до 30 секунд.
- Стоимость обращения к нейросети: около 1,5–3 ₽ за обращение, когда сервис ищет несколько тем, и около 0,1 ₽ в режиме одной темы.
Цены посчитаны на тестах, где нейросети работали через российский сервис HydraAI с оплатой в рублях. Если заказчик подключит свою модель на своих серверах, платить внешнему сервису за каждое обращение не придётся.
Персональные данные и безопасность
Обращения граждан полны личных данных: имена, адреса, телефоны, подробности о семье и здоровье. Поэтому защиту мы закладывали с первого дня.
- Сразу после распознавания фамилии, имена, телефоны и адреса заменяются метками. Подбор тем идёт по тексту уже без них.
- Журнал работы сервиса не хранит текст обращений.
- Примеры разметки экспертов, на которые опирается сервис, тоже обезличены.
- Сервис работает без прав администратора на сервере.
- Нейросеть подключается по стандартному способу, поэтому её можно заменить на свою, установленную внутри ведомства. Тогда сканы обращений не покидают сеть заказчика даже до обезличивания.
По требованию службы безопасности заказчика сервис запускают у себя их специалисты.
Что получилось
Сервис принимает обращение в любом виде: текст, PDF, Word, скан, фото, рукописное письмо. Он читает длинные документы целиком, убирает личные данные и выдаёт всё для регистрации: тематику по классификатору, вид и тип вопроса. В одном обращении он находит несколько тем, объясняет каждую и предлагает запасные варианты. Сотрудник проверяет готовый список в панели, а не ищет темы с нуля.
По итогам сверки с экспертами приёмной:
- в обращениях с несколькими темами сервис нашёл 80% тем, и 96% выданного оказалось верным;
- в обращениях с одной темой нашёл 94% тем;
- главная тема одиночных обращений совпала в 15 из 16 случаев против 12 из 16 на первом этапе.
12 октября 2026 года мы передали заказчику архив: исходный код, готовый контейнер и инструкцию по запуску. Развёртывание и связку с СЭДД заказчик делает своими силами. Сколько часов сервис сэкономит приёмной, покажет работа на живом потоке. Таких замеров пока нет, и мы не выдаём ожидания за результат.
Кому подойдёт такой сервис
Похожая задача есть у любой организации, куда приходит много писем и каждое нужно отнести к теме по своему справочнику. Это обращения граждан в органах власти, жалобы клиентов в крупной компании, заявки в службу поддержки, входящие письма в документообороте.
Что можно взять из этого проекта:
- распознавание длинных сканов и рукописных писем без потери страниц;
- обезличивание до того, как текст уходит в нейросеть;
- подбор нескольких тем по большому справочнику с объяснением каждой;
- панель, где сотрудник проверяет и правит ответ, а не делает работу заново;
- порог, после которого простые случаи идут без человека;
- работу на своих серверах, если данные нельзя выносить наружу.
Начинаем всегда с проверки на ваших же данных, как здесь: берём размеченные письма, считаем, сколько сервис находит и сколько ошибается, и показываем расхождения вашим экспертам. Подробнее о том, как мы делаем такие системы, на странице ИИ-агенты для бизнеса под ключ.
Для технических специалистов
- Сервис: FastAPI в Docker, контейнер запускается без прав root. Документация программного интерфейса встроена в сервис.
- Модель: подключается через API, совместимый с OpenAI. На тестах работали DeepSeek и Gemini через российский шлюз HydraAI с оплатой в рублях, без зарубежных прокси. В контуре заказчика можно подключить свою модель.
- Распознавание: документ режется на части по 3 страницы, части распознаются параллельно и собираются по порядку. 27 страниц примерно за 30 секунд. Для рукописных писем включается более точная модель.
- Классификатор: редакция от 31.10.2025, 9 видов вопроса, типы видов, около 1 870 листовых тематик в 5 разделах. Поиск по классификатору идёт через отдельный метод.
- Ответ: JSON с основной и дополнительными темами (themes), запасными кандидатами (themeCandidates), видом и типом вопроса с оценкой уверенности и блоком routing: решение, порог и причины, если ответ ушёл на сверку.
- Несколько тем: два прохода. Первый собирает широкий список кандидатов по полному классификатору, второй отбирает темы с опорой на обезличенные примеры разметки экспертов.
- Порог: настраивается в конфигурации, сейчас 1.0, то есть все ответы идут на сверку.
- Журнал: без текста обращений.
Услуги по теме
Похожие кейсы
Разбор вашего потока обращений
Расскажите, сколько писем приходит и по какому справочнику их разбирают. За 40 минут скажем, что можно отдать сервису и что оставить людям.
Если сервис вам не нужен, так и скажем. Свяжемся так, как вы выбрали. Пн–Вс 8–21 по НСК.
